Die Co-Brainers Guardrails Engine
Wie unsere Systemarchitektur gleichzeitig Inferenzkosten um bis zu 70 % senkt und kompromisslose B2B-Qualität garantiert. Ein Leitfaden für Software-Entwickler und Business Entscheider.

Halluziniere ich noch oder digitalisiere ich schon?
Es ist schon ein echtes Dilemma mit der künstlichen Intelligenz im professionellen Einsatz, oder? Ich
glaube, egal wo man sich persönlich gerade auf der Reise in die schöne neue KI-Welt befindet, wir alle
machen
ähnliche Erfahrungen.
Zuerst wirken die Antworten von chatGPT, Gemini und Co. beeindruckend smart und es hat etwas von
Zauberei. Anfängliche Skepsis weicht einem trügerischen Vertrauen. Alles ist ja auch so schön einfach.
Bequem wie man ist, ertappt man sich dann
später dabei, Inhalte 1:1 zu übernehmen und macht ggf. lieber früher Feierabend, statt nochmal genauer
hinzusehen.
Im professionellen Kontext mag das im Innenverhältnis ja noch gerade so glimpflich ablaufen, obwohl auch
hier der Ärger vorprogrammiert ist.
Die KI-Ergebnisse 1:1 ungeprüft in die Quartalspräsentation übernommen.
Aber im Außenverhältnis riskiert man, wenn's gut ausgeht, bestenfalls nur ein wenig Reputation. Im
schlimmsten Fall aber verliert man Kunden oder riskiert rechtliche Schritte.
Selbst wenn man vorsichtiger agiert und genauer hinsieht: Hin und wieder schleichen sich Ungenauigkeiten
und Fehler ein, die man zunächst wohlwollend ignoriert bzw. man hilft dem fleißigen Helferlein auf die
Sprünge – Reprompting nennt man das.
Es bezeichnet den Vorgang, dass der Nutzer erst nach mehrfachem Nachfragen zum korrekten Ergebnis kommt.
Mancher landet sogar verzweifelt in einer Endlosschleife mit dem Chatbot seiner Wahl – in der Tech-Szene
bezeichnet
man das treffend als Doomprompting (oder Prompt Doom Loop) – und das ist
extrem ineffizient und kostspielig.
Das sei, solange man das privat macht oder der Chef am Ende immer noch mit den Ergebnissen zufrieden
ist, jedem selbst überlassen.
„Nur noch eine kleine Anpassung... bitte als Tabelle und ohne Bananen!“ – Man hilft dem fleißigen Helferlein geduldig auf die Sprünge.
5 Espressi später und 40 Korrektur-Prompts tiefer in der Endlosschleife: Die KI verspricht stets treuherzig: „Sorry! Let me try again!“
In der Echtzeit-Kundenkommunikation, egal ob am Telefon oder im Live-Chat, wollen Sie solche
Überraschungen jedoch auf
gar keinen Fall erleben.
Wo genau liegt also das Problem für mich als Geschäftsinhaber?
Anders als bei einer internen Präsentation oder einem unverbindlichen Chatbot gibt es bei der automatisierten Echtzeit-Kundenkommunikation über Telefon, Webchat oder Messaging kein Sicherheitsnetz. Soll heißen: Die KI muss sich zu 100 % an die Regeln und Inhalte halten, die Sie ihr auferlegen (Instruction Following). Andernfalls fallen falsche Informationen, aber auch falsche Handlungen (z. B. eine fehlerhafte Buchung), immer direkt auf Sie als Geschäftsinhaber zurück.
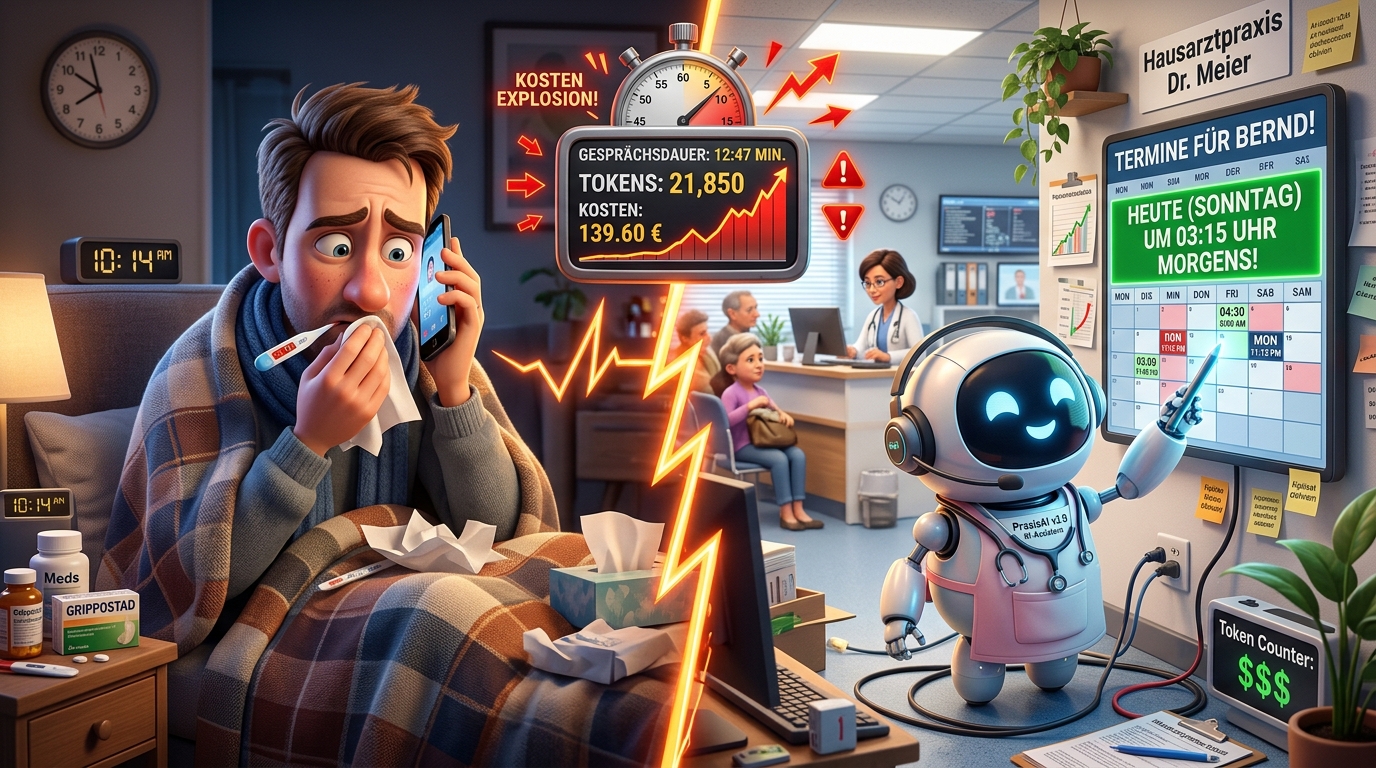
Wenn unkontrollierte Sprachmodelle telefonieren: Der kranke Anrufer erhält einen Termin für „Sonntag um 03:15 Uhr morgens“ – während Gesprächsdauer, Tokenverbrauch und Inferenzkosten ins Unermessliche schießen.
Hier drei besonders häufige, reale Praxisszenarien für diese Problematik:
1. Der Geistertermin am geschlossenen Praxistag (Medizin & Gesundheit)
Ein Patient ruft mit Fieber an. Das Sprachmodell beruhigt den Anrufer wortreich, ignoriert die hinterlegten Praxis-Schließzeiten und bucht ihn für den kommenden Mittwoch um 15:30 Uhr ein – an einem Tag, an dem die Praxis wegen Fortbildung geschlossen ist. Der Patient steht vor verschlossener Tür; im schlimmsten Fall haftet die Praxis für Verzögerungen bei einer Akutbehandlung.
2. Die verschenkte Notdienstpauschale (Handwerk & Service)
Ein Kunde meldet am Sonntagabend einen Rohrbruch. Das Modell plaudert hilfsbereit, vergisst jedoch die vertragliche Notdienstpauschale von 160 € und sagt mündlich zu: „Unser Monteur kommt sofort vorbei, wir regeln das unbürokratisch auf Kulanz.“ Der Kunde beruft sich auf das Bandprotokoll – der Handwerksbetrieb bleibt auf den Einsatzkosten sitzen.
3. Der Doppelbuchungs-Kollaps (Termin- & Kanzleialltag)
Zwei Mandanten rufen parallel an. Weil herkömmliche Bot-Systeme keine atomare Datenbanksperre (Mutex) im Hintergrund besitzen, bestätigt die KI beiden Anrufern denselben 10:00-Uhr-Slot. Um 10:00 Uhr treffen zwei verärgerte Klienten gleichzeitig an der Rezeption aufeinander – peinlich für den Inhaber und ein sofortiger Vertrauensverlust.
Wie andere Anbieter versuchen, dieses Problem zu lösen
Genau an dieser Stelle trennt sich im Markt die Spreu vom Weizen. Die meisten Anbieter von KI-Telefonassistenten machen es sich schlicht zu einfach: Sie bauen im Grunde nur einen hübsch gestalteten SaaS-Wrapper um die Standard-Schnittstellen US-amerikanischer KI-Konzerne (OpenAI, Anthropic).
Tritt im Produktiveinsatz eine Halluzination oder ein Regelfehler auf, lautet ihre einzige Antwort: „Wir schalten beim nächsten Update einfach das noch größere, noch mächtigere Flaggschiff-Modell davor.“
Das ist kein Software-Engineering, sondern das teure Überdecken architektonischer Schwächen mit roher Rechenpower. Die Zeche dafür zahlen Sie als Kunde gleich dreifach:
- Explodierende Inferenz- und Tokenkosten: Größere Modelle verbrauchen drastisch mehr Rechenzeit und kosten ein Vielfaches pro Minute – der Grund für teure Monatsabos und Minutenpreise von bis zu 50 Cent bei der Konkurrenz.
- Gefährlicher Vendor Lock-in: Wer seine gesamte Geschäftslogik unstrukturiert an ein einzelnes US-Modell koppelt, ist Preiserhöhungen, API-Änderungen und Serverausfällen der Anbieter schutzlos ausgeliefert.
- Verzweifelte Notlösungen: Um die ausufernden Kosten dann doch irgendwie im Zaum zu halten, greifen solche Wrapper-Lösungen fast immer zu zwei untauglichen Notnägeln:
Man stopft alle Geschäftsregeln, Dienstleistungen, Preise und Historien in einen riesigen Prompt. Die Folge: Explodierende Inferenzkosten, träge Latenzen (Time-to-First-Token > 1.000 ms) und das Phänomen „Lost-in-the-Middle“ (Stanford-Studie, Liu et al.). Wie die Voice-Benchmarks von Artificial Analysis für GPT-4o und Gemini belegen, sprengen aufgeblähte Prompts die für Telefonate kritische Latenzgrenze von 300–500 ms drastisch – die KI fängt am Telefon hörbar an zu stocken.
Man verknappt den Prompt radikal, um Kosten und Latenz zu drücken. Die Folge: Das Modell verliert den Kontext und verfällt in erforschte Gefallsucht (Anthropic Research: „Towards Understanding Sycophancy“): Es erfindet freie Termine oder gibt falsche Auskünfte, nur um dem Anrufer zuzustimmen. Ein untragbares Haftungsrisiko im B2B-Betrieb.
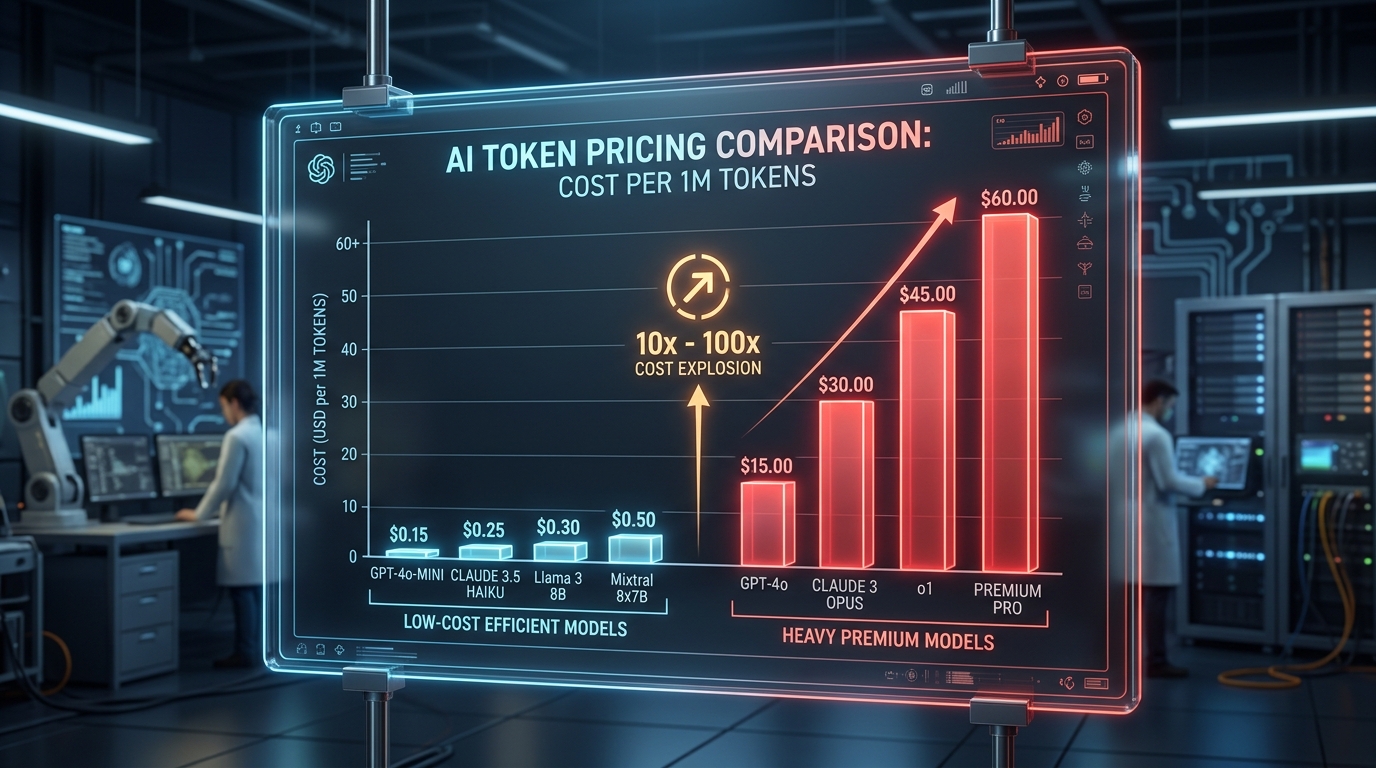
Visualisierung des Preisgefälles: Links die veralteten, günstigeren Modelle (z.B. GPT-4o-mini), rechts die neuen Premium-Modelle (z.B. GPT-5.1, GPT-5.1-mini) mit deutlich höheren Preisen pro Token. Dies verdeutlicht, warum andere Anbieter gezwungen sind, höhere Gebühren an ihre Kunden weiterzureichen.
Wir lösen das einfach.anders: Die Co-Brainers Guardrails Engine
Unsere architektonische Grundüberzeugung bei Co-Brainers lautet:
Benchmarkreife Kundenerfahrung
*
Wahre B2B-Zuverlässigkeit
*
und radikale Wirtschaftlichkeit
*
gehen kompromisslos zusammen
Voraussetzung dafür ist aber, dass man den Kundendialog und die Geschäftslogik nicht dem probabilistischen Modell allein überlässt, sondern vielmehr die Stärken eines deterministischen Ansatzes für die Abarbeitung von geschäftskritischen Abläufen integriert und dabei mit Hilfe unseres Entity-Cachings eine verifizierte Ground-Truth-Baseline als Halluzinationsfilter nutzt.
Die Architektur im Überblick: Wo Kosten sinken und Qualität entsteht
Die Guardrails Engine ist keine simple Prompt-Schablone, sondern eine vollständige, flow-agnostische Plattform-Architektur. Sie trennt die Sprach-KI strikt in zwei voneinander isolierte Wirkungskreise:
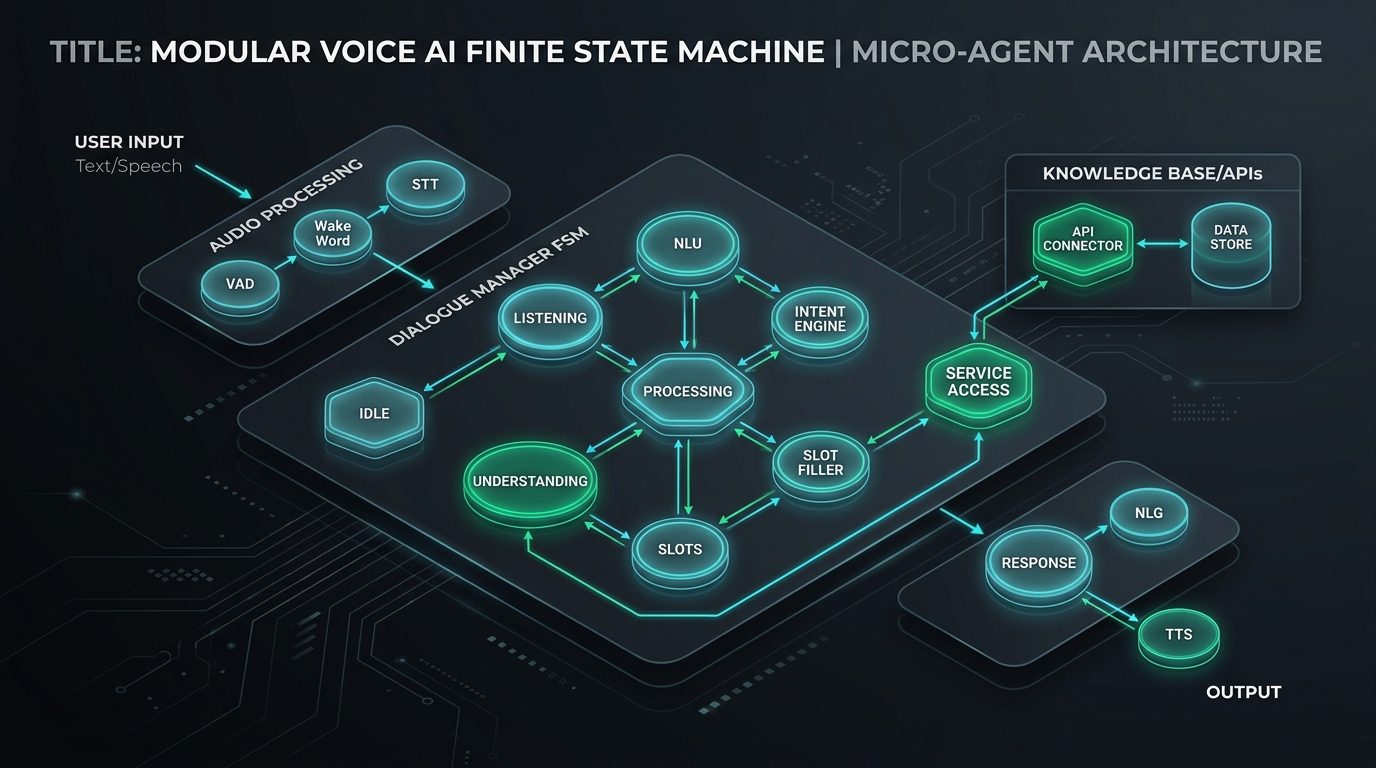
Abbildung: Systemarchitektur der Co-Brainers Guardrails Engine – Klare Entkopplung von Inferenz-Routing (FSM) und deterministischer Backend-Validierung (Gatekeeper).
Anhand dieser Systemgrafik wird sichtbar, an welchen Stellen der Pipeline die beiden entscheidenden B2B-Mehrwerte erzeugt werden:
→ Hier entsteht der Kostenvorteil (Token-Ökonomie)
Statt eines Monolithen steuert eine modulare Finite-State-Machine den Dialog. Jeder Zustand (Idle, Listening, Understanding, Slot Filler) lädt Just-in-Time nur ein Micro-Prompt-Budget. Das spart 70 % Rechenkosten und drückt die Latenz unter 300 Millisekunden.
→ Hier entsteht die fehlerfreie B2B-Qualität
Das Sprachmodell hat keinen direkten Schreibzugriff auf Kalender oder Datenbanken. Das Backend fungiert als unbestechlicher Gatekeeper: Es prüft vor jeder Aktion mathematisch deterministisch, ob die geforderten Daten autorisiert und valide sind.
Die Token-Ökonomie – 70 % weniger Inferenzkosten & sub-300ms Latenz
Der Begriff „Token-Ökonomie“ beschreibt die disziplinierte Bewirtschaftung des Kontextfensters. Während herkömmliche Telefonbots bei jedem Satz tausende überflüssige Tokens durch die GPU-Prefill-Phase jagen, operationalisiert unsere Guardrails Engine vier fundamentale Engineering-Säulen:
Prompts existieren nicht als statische Texte. Erst in der Millisekunde des Audio-Turns assembliert das Backend den Prompt modular aus vorkompilierten Bausteinen: Systemidentität, aktuelle Phasenziele und dynamische Werkzeuge.
Kein unkontrollierter Datenbank-Dump. Der Micro-Agent erhält nur genau die Entitäten, die er für seine Entscheidung braucht – z. B. exakt zwei vorselektierte Kalenderslots statt des Monatskalenders oder komprimierte Stammdaten (~40 Tokens).
Lange Chat-Historien erzeugen Kontext-Drift. Unser System extrahiert erkannte Parameter (Name, Anliegen, SlotId) sofort atomar in ein typisiertes Session-Objekt. Der rohe Sprach-Chat-Verlauf wird gecleant, statt sich endlos aufzublähen.
Jeder Audio-Turn unterliegt einem harten Token-Budget von maximal 200–400 Input-Tokens und 15–30 Output-Tokens. Das minimiert die GPU-Prefill-Phase und hält die Time-to-First-Token (TTFT) konstant unter 300 Millisekunden.
Flow-agnostische Architektur: Volle Flexibilität bei maximaler Token-Disziplin
Wie viele Zustände, Verzweigungen oder Rückfragen ein Dialog umfasst, bestimmt allein das individuelle Flow-Design Ihres Anwendungsfalls – von der kompakten Notfall-Erfassung im Handwerksbetrieb bis zur mehrstufigen Kalenderbuchung in einer Arztpraxis.
Die architektonische Konstante: Egal wie verzweigt der Gesamt-Flow ist – in jedem einzelnen Audio-Turn isoliert unsere Guardrails Engine den aktiven Zustand und injiziert Just-in-Time (JIT) nur die dafür notwendigen 200 bis 400 Tokens. Das LLM konzentriert sich immer nur auf ein einziges atomares Teilziel. Der Kontext bleibt über das gesamte Gespräch hinweg schlank, blitzschnell und frei von Rauschen.
| Architektur-Kriterium | Herkömmliche Telefon-Bots | Co-Brainers Guardrails Engine |
|---|---|---|
| Prompt-Design | Monolithisch (4.000–6.000 Tokens) | Modulare State-Machine (200–400 Tokens) |
| Prefill-Latenz (TTFT) | 800 – 1.400 ms (spürbare Sprechpause) | < 300 ms (sofortige Audio-Reaktion) |
| Verbrauchte Tokens / Anruf | ca. 60.000 – 90.000 Tokens | ca. 4.000 – 8.000 Tokens (-85 %) |
| Auswirkung auf Minutenpreis | Teuer (30 bis 50 Cent / Minute) | Bestpreis (ab 6,25 bis 10 Cent / Minute) |
Zero-Trust-Entity-Caching – Deterministischer Halluzinationsschutz durch eine verifizierte Ground-Truth-Baseline
Ein weit verbreiteter Irrglaube lautet: „Wenn man das Kontextfenster nur klein genug hält, halluziniert das Modell nicht mehr.“
Als Software-Ingenieure wissen wir: Nein, wenige Tokens schließen Halluzinationen keineswegs mathematisch aus. Ein Large Language Model ist ein stochastischer Papagei. Wenn ein Anrufer am Telefon drängt („Haben Sie nicht doch am Dienstag um 14 Uhr Zeit?“), neigt jedes neuronale Netz dazu, aus Gefallsucht (Sycophancy) einen Termin zu bestätigen – ganz egal, wie kurz der Prompt war.
Darum verlassen wir uns bei geschäftskritischen Buchungen nicht auf gewöhnliches „Function Calling“ der Standardmodelle. Wie das maßgebliche Berkeley Function Calling Leaderboard (BFCL) der UC Berkeley fortlaufend belegt, scheitern selbst führende Flaggschiff-Sprachmodelle bei komplexen Multi-Turn-Dialogen regelmäßig an fehlerhaften Tool-Parametern oder rufen Schnittstellen mit erfundenen Daten auf.
Deshalb verfolgt die Guardrails Engine einen kompromisslosen Zero-Trust-Ansatz: Das Sprachmodell darf niemals direkt Schreibaktionen in Kundendatenbanken oder Kalender ausführen. Stattdessen basiert unsere Sicherheit auf einem geschlossenen Dreiklang aus Entity-Caching, der Ground-Truth-Baseline und dem Exposure-Audit-Control.
Das Zusammenspiel: Wie Entity-Cache, Ground-Truth und Exposure-Audit-Control ineinandergreifen
Halluzinationen entstehen immer dann, wenn Sprachmodelle über Fakten spekulieren dürfen. In unserer Architektur wird das Modell vollständig von der Datenhoheit isoliert:
Das Backend lädt vor jedem Schritt echte Geschäftsdaten (z. B. freie Termine, Tarife) direkt aus dem führenden System (eTermin, Doctolib, CRM) in einen geschützten Session-Cache. Das LLM hat darauf keinen direkten Schreib- oder Lesezugriff.
Nur Entitäten im Cache existieren in der System-Realität. Was nicht in der Baseline steht, ist für das Backend schlicht physikalisch unmöglich – egal, was ein Anrufer verlangt oder die KI verspricht.
Nur wenn das Backend einen Slot aktiv in das Micro-Prompt des aktuellen Gesprächsschritts einspeist, wird das im Exposure-Audit-Control nachgehalten. Es ist der Audit-Nachweis: Dieser Slot wurde dem LLM nachweislich autorisiert vorgelegt.
Warum das Exposure-Audit-Control die entscheidende Sicherheitsbarriere ist
In herkömmlichen Voice-AI-Setups ruft das Modell bei einer Buchung blind eine Funktion mit
Freitext-Parametern auf (z. B. book(time: "Sonntag, 03:15 Uhr")). Redet ein Anrufer
dem Modell ein, dass ein Notfalltermin um 3 Uhr nachts existiert, führt die KI den Funktionsaufruf
stochastisch aus – und das Backend stürzt ab oder generiert fatale Geisterbuchungen.
In unserer Architektur hat das Sprachmodell keinerlei Möglichkeit, Zeitpunkte, Preise oder Bedingungen frei zu erfinden. Es kann lediglich eine ID referenzieren. Und selbst wenn das Modell versucht, eine gültige ID zu erraten, die im System existiert, aber dem Anrufer gar nicht angeboten wurde, schlägt der Riegel zu:
-
Slot existiert nicht im Entity-Cache? Sofortiger Abbruch (
!slot). Die Phantasie des Modells scheitert sofort an der realen Ground-Truth-Baseline. - Slot existiert, wurde aber im Dialog nie aktiv freigegeben? Sofortiger Abbruch. Das Modell kann keine internen Kalenderdaten buchen, die dem Anrufer vom Backend nicht explizit als wählbare Option vorgelegt wurden.
- Slot wurde nachweislich autorisiert exponiert? Erst jetzt öffnet der Gatekeeper die Buchungsschleuse und führt die Reservierung atomar mit Mutex-Sperre im Primärsystem (z. B. eTermin, Doctolib oder CRM) aus.
Das Ergebnis: Das Modell besitzt die Freiheit, hochgradig empathisch, flexibel und menschlich zu formulieren – aber null mathematische Freiheit, geschäftliche Fakten zu verfälschen. Wahrheit (Backend-Entity-Cache) und Sprache (LLM-Inferenz) sind strikt voneinander entkoppelt.
5. Der ökonomische Hebel: Warum Spitzenqualität nicht teuer sein muss
Viele Unternehmen wundern sich, warum Co-Brainers Pakete mit 0 € monatlicher Grundgebühr und Minutenpreise zwischen 6,25 und 10 Cent anbieten kann – während etablierte Marktteilnehmer 150 bis 250 € monatlich und 35 bis 50 Cent pro Minute verlangen.
Die Antwort liegt nicht in Dumping oder billigen Abstrichen bei der Qualität. Die Antwort liegt in der Guardrails Engine:
Hohe Effizienz + Geringer Ressourcenverbrauch = Bester Preis am Markt
Weil unsere Guardrails Engine bis zu 70 % der Server- und GPU-Inferenzkosten einspart und Ausfälle durch Halluzinationen eliminiert, behalten wir diese Marge nicht für einen aufgeblähten Vertriebsapparat ein – sondern geben sie direkt als Bestpreis an unsere Kunden weiter.
Erleben Sie fehlerfreie Sprach-KI in Aktion
Testen Sie unseren Telefonassistenten 14 Tage kostenlos und unverbindlich. Überzeugen Sie sich selbst von der sub-300ms Reaktionszeit und 100 % fehlerfreier Terminierung.
Ⓒ 2026 Co-Brainers. Alle Rechte vorbehalten.