Die Co-Brainers Guardrails Engine
Wie unsere Systemarchitektur gleichzeitig Inferenzkosten um bis zu 70 % senkt und kompromisslose B2B-Qualität garantiert. Ein technischer Leitfaden für Software-Entwickler und Entscheider.

Autor & Systemarchitektur
Andre Danner
Co-Brainers · Software-Architektur für Realtime Voice AI
1. Das Dilemma moderner Sprach-KI: Hohe Kosten oder fehlerhafte Qualität?
Wer heute Sprach-KI im professionellen B2B-Umfeld einsetzt – sei es in der Patientenkommunikation von Arztpraxen, im Notdienst von Handwerksbetrieben oder im Kanzleialltag –, stößt bei herkömmlichen Systemen unweigerlich auf ein scheinbar unlösbares Dilemma:
Man stopft alle Geschäftsregeln, Dienstleistungen, Preise und Historien in einen riesigen Prompt. Die Folge: Explodierende Inferenzkosten, träge Latenzen (Time-to-First-Token > 1.000 ms) und das Phänomen „Lost-in-the-Middle“, bei dem das Modell Anweisungen überliest.
Man verknappt den Prompt radikal, um Kosten und Latenz zu drücken. Die Folge: Das Modell verliert den Kontext, erfindet aus Gefallsucht (Sycophancy) freie Termine oder gibt falsche Auskünfte. Ein untragbares Haftungsrisiko im B2B-Betrieb.
Unsere architektonische Grundüberzeugung bei Co-Brainers lautet: Wahre B2B-Zuverlässigkeit und radikale Wirtschaftlichkeit schließen sich nicht aus – vorausgesetzt, man überlässt die Geschäftslogik nicht dem probabilistischen Modell, sondern löst sie auf Systemebene.
Die Antwort darauf ist die Co-Brainers Guardrails Engine.
2. Die Architektur im Überblick: Wo Kosten sinken und Qualität entsteht
Die Guardrails Engine ist keine simple Prompt-Schablone, sondern eine vollständige, flow-agnostische Plattform-Architektur. Sie trennt die Sprach-KI strikt in zwei voneinander isolierte Wirkungskreise:
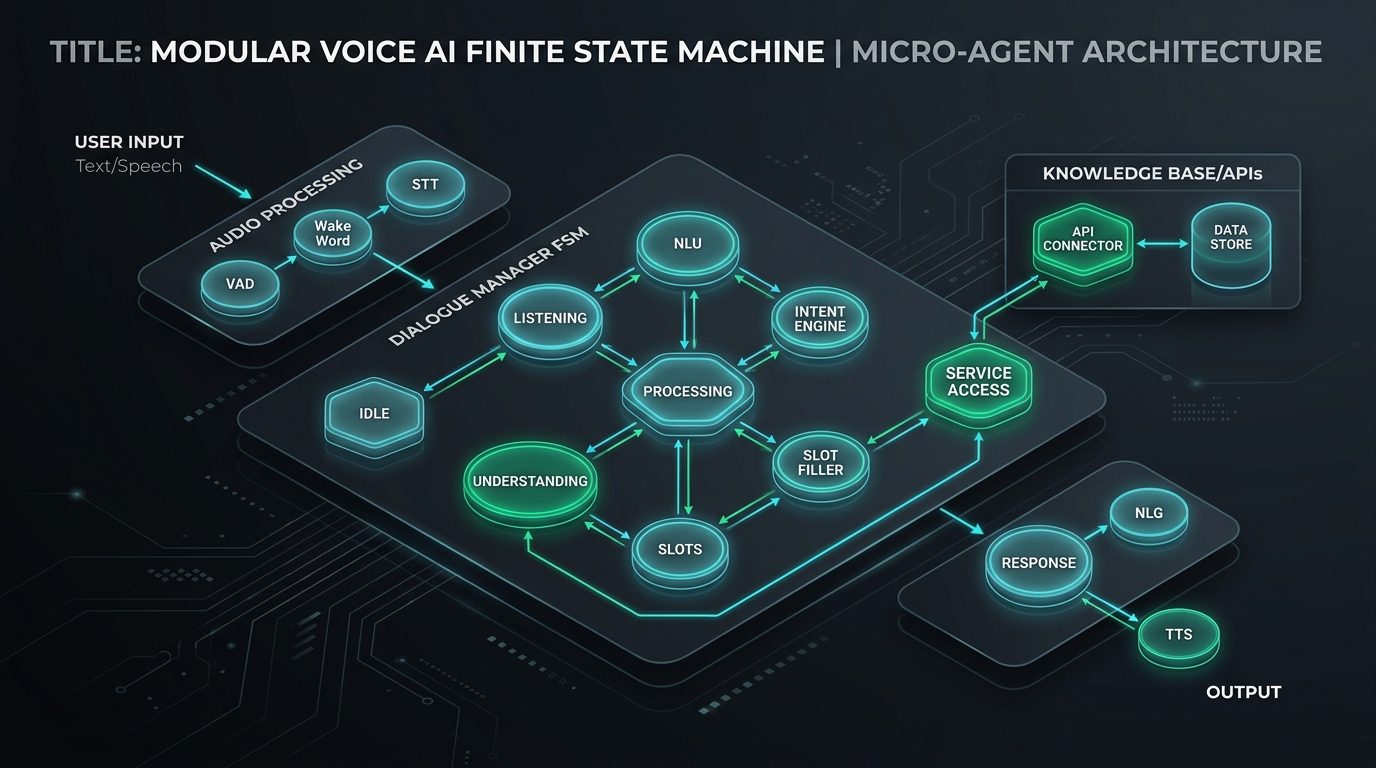
Abbildung: Systemarchitektur der Co-Brainers Guardrails Engine – Klare Entkopplung von Inferenz-Routing (FSM) und deterministischer Backend-Validierung (Gatekeeper).
Anhand dieser Systemgrafik wird sichtbar, an welchen Stellen der Pipeline die beiden entscheidenden B2B-Mehrwerte erzeugt werden:
→ Hier entsteht der Kostenvorteil (Token-Ökonomie)
Statt eines Monolithen steuert eine modulare Finite-State-Machine den Dialog. Jeder Zustand (Idle, Listening, Understanding, Slot Filler) lädt Just-in-Time nur ein Micro-Prompt-Budget. Das spart 70 % Rechenkosten und drückt die Latenz unter 300 Millisekunden.
→ Hier entsteht die fehlerfreie B2B-Qualität
Das Sprachmodell hat keinen direkten Schreibzugriff auf Kalender oder Datenbanken. Das Backend fungiert als unbestechlicher Gatekeeper: Es prüft vor jeder Aktion mathematisch deterministisch, ob die geforderten Daten autorisiert und valide sind.
3. Beitrag 1: Die Token-Ökonomie – 70 % weniger Inferenzkosten & sub-300ms Latenz
Der Begriff „Token-Ökonomie“ beschreibt die disziplinierte Bewirtschaftung des Kontextfensters. Während herkömmliche Telefonbots bei jedem Satz tausende überflüssige Tokens durch die GPU-Prefill-Phase jagen, operationalisiert unsere Guardrails Engine vier fundamentale Engineering-Säulen:
Prompts existieren nicht als statische Texte. Erst in der Millisekunde des Audio-Turns assembliert das Backend den Prompt modular aus vorkompilierten Bausteinen: Systemidentität, aktuelle Phasenziele und dynamische Werkzeuge.
Kein unkontrollierter Datenbank-Dump. Der Micro-Agent erhält nur genau die Entitäten, die er für seine Entscheidung braucht – z. B. exakt zwei vorselektierte Kalenderslots statt des Monatskalenders oder komprimierte Stammdaten (~40 Tokens).
Lange Chat-Historien erzeugen Kontext-Drift. Unser System extrahiert erkannte Parameter (Name, Anliegen, SlotId) sofort atomar in ein typisiertes Session-Objekt. Der rohe Sprach-Chat-Verlauf wird gecleant, statt sich endlos aufzublähen.
Jeder Audio-Turn unterliegt einem harten Token-Budget von maximal 200–400 Input-Tokens und 15–30 Output-Tokens. Das minimiert die GPU-Prefill-Phase und hält die Time-to-First-Token (TTFT) konstant unter 300 Millisekunden.
Flow-agnostische Architektur: Volle Flexibilität bei maximaler Token-Disziplin
Wie viele Zustände, Verzweigungen oder Rückfragen ein Dialog umfasst, bestimmt allein das individuelle Flow-Design Ihres Anwendungsfalls – von der kompakten Notfall-Erfassung im Handwerksbetrieb bis zur mehrstufigen Kalenderbuchung in einer Arztpraxis.
Die architektonische Konstante: Egal wie verzweigt der Gesamt-Flow ist – in jedem einzelnen Audio-Turn isoliert unsere Guardrails Engine den aktiven Zustand und injiziert Just-in-Time (JIT) nur die dafür notwendigen 200 bis 400 Tokens. Das LLM konzentriert sich immer nur auf ein einziges atomares Teilziel. Der Kontext bleibt über das gesamte Gespräch hinweg schlank, blitzschnell und frei von Rauschen.
| Architektur-Kriterium | Herkömmliche Telefon-Bots | Co-Brainers Guardrails Engine |
|---|---|---|
| Prompt-Design | Monolithisch (4.000–6.000 Tokens) | Modulare State-Machine (200–400 Tokens) |
| Prefill-Latenz (TTFT) | 800 – 1.400 ms (spürbare Sprechpause) | < 300 ms (sofortige Audio-Reaktion) |
| Verbrauchte Tokens / Anruf | ca. 60.000 – 90.000 Tokens | ca. 4.000 – 8.000 Tokens (-85 %) |
| Auswirkung auf Minutenpreis | Teuer (30 bis 50 Cent / Minute) | Bestpreis (ab 6,25 bis 10 Cent / Minute) |
4. Beitrag 2: Zero-Trust gegenüber dem LLM – Deterministischer Halluzinationsschutz durch shownToLlm
Ein weit verbreiteter Irrglaube lautet: „Wenn man das Kontextfenster nur klein genug hält, halluziniert das Modell nicht mehr.“
Als Software-Ingenieure wissen wir: Nein, wenige Tokens schließen Halluzinationen keineswegs mathematisch aus. Ein Large Language Model ist ein stochastischer Papagei. Wenn ein Anrufer am Telefon drängt („Haben Sie nicht doch am Dienstag um 14 Uhr Zeit?“), neigt jedes neuronale Netz dazu, aus Gefallsucht (Sycophancy) einen Termin zu bestätigen – ganz egal, wie kurz der Prompt war.
Deshalb verfolgt die Guardrails Engine einen kompromisslosen Zero-Trust-Ansatz: Das Sprachmodell darf niemals direkt Schreibaktionen in Kundendatenbanken oder Kalender ausführen.
Die mathematische Garantie liegt im Backend-Gatekeeper:
Jeder Slot und jede Dienstleistung im Cache trägt ein Audit-Feld. Nur wenn das Backend einen freien Termin aktiv in den Dialog injiziert hat, wird shownToLlm inkrementiert.
Will das Modell am Ende eine Buchung für einen erfundenen Wunschtermin des Anrufers ausführen, bricht das Backend die Transaktion deterministisch ab (shownToLlm <= 0).
Das Modell kann sprechen, was es will – im realen Kalender oder CRM kann niemals eine Phantasie- oder Doppelbuchung entstehen.
5. Der ökonomische Hebel: Warum Spitzenqualität nicht teuer sein muss
Viele Unternehmen wundern sich, warum Co-Brainers Pakete mit 0 € monatlicher Grundgebühr und Minutenpreise zwischen 6,25 und 10 Cent anbieten kann – während etablierte Marktteilnehmer 150 bis 250 € monatlich und 35 bis 50 Cent pro Minute verlangen.
Die Antwort liegt nicht in Dumping oder billigen Abstrichen bei der Qualität. Die Antwort liegt in der Guardrails Engine:
Hohe Effizienz + Geringer Ressourcenverbrauch = Bester Preis am Markt
Weil unsere Guardrails Engine bis zu 70 % der Server- und GPU-Inferenzkosten einspart und Ausfälle durch Halluzinationen eliminiert, behalten wir diese Marge nicht für einen aufgeblähten Vertriebsapparat ein – sondern geben sie direkt als Bestpreis an unsere Kunden weiter.
Warum herkömmliche Telefon-KIs Termine erfinden – und wie Co-Brainers Doppelbuchungen ausschließt
Sie suchen eine anschauliche Zusammenfassung für Geschäftsführung oder Kunden ohne tiefes Informatik-Wissen? Erfahren Sie, wie unsere Schranke Doppelbuchungen im Betriebsalltag unmöglich macht.
Erleben Sie fehlerfreie Sprach-KI in Aktion
Testen Sie unseren Telefonassistenten 14 Tage kostenlos und unverbindlich. Überzeugen Sie sich selbst von der sub-300ms Reaktionszeit und 100 % fehlerfreier Terminierung.
Ⓒ 2026 Co-Brainers. Alle Rechte vorbehalten.